Quinze TV boxes dividiram o trabalho de executar uma IA. O resultado foi cerca de um token a cada 2,6 segundos.
Ilustração conceitual gerada por IA / Mais FPS. Não é captura real.
A conta e a espera
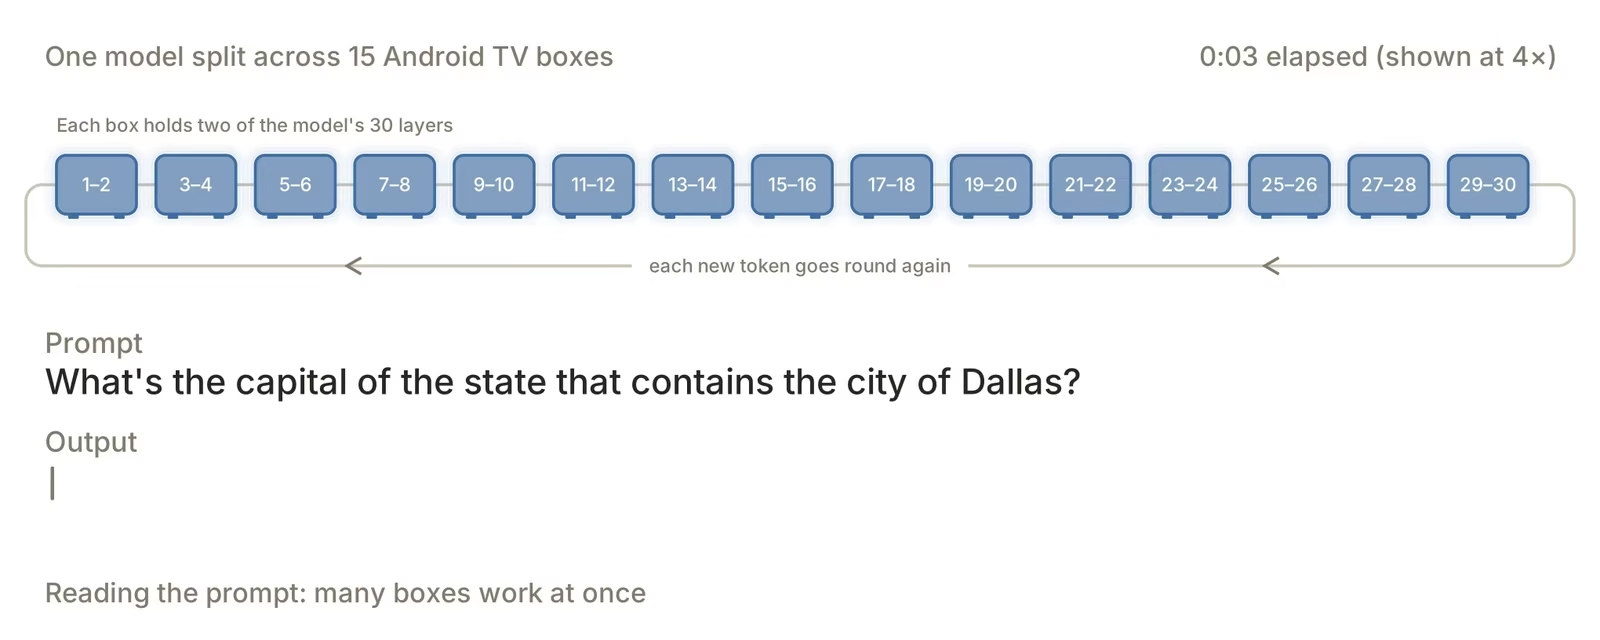
A Anthropic dividiu uma IA entre 15 TV boxes de cerca de US$55 cada: aproximadamente US$825 só em aparelhos.
A IA rodou a 0,39 token por segundo, ou cerca de um token a cada 2,6 segundos.
Um token é um fragmento de texto: pode ser uma palavra ou apenas parte dela, conforme a explicação da Hugging Face. Portanto, uma única frase pode exigir vários tokens. Dá para imaginar a paciência necessária para conversar nesse ritmo.
Por que juntar tantas caixas
Um modelo de IA precisa caber na memória para trabalhar. Dividi-lo permite somar a capacidade de várias máquinas: cada uma guarda uma parte e passa os resultados para a seguinte. É o princípio de projetos como o Petals. O preço dessa divisão é a comunicação entre os aparelhos, que também leva tempo.
Ela conseguiria continuar sozinha?
Uma IA conseguiria encontrar outro computador, copiar-se para ele e continuar funcionando sem ajuda humana? O estudo investiga essa autonomia e o risco de usar máquinas sem autorização.
Num teste separado, os pesquisadores facilitaram o acesso a computadores que imitavam TV boxes. Uma IA num servidor separado instalou outra IA neles. O experimento não demonstrou uma IA se copiando e continuando a funcionar por conta própria fora das condições preparadas pelos pesquisadores.
Fontes
- Anthropic — AI models may be capable of self-replicating without access to a datacenter (2026-10-12)
- Petals: Collaborative Inference and Fine-tuning of Large Models (2023-03-02)
- Hugging Face — Tokenizers (Consultado em 2026-10-13)