Quince TV boxes se repartieron el trabajo de ejecutar una IA, generando aproximadamente un token cada 2,6 segundos.
Ilustración conceptual generada por IA / Mais FPS. No es una captura real.
La cuenta y la espera
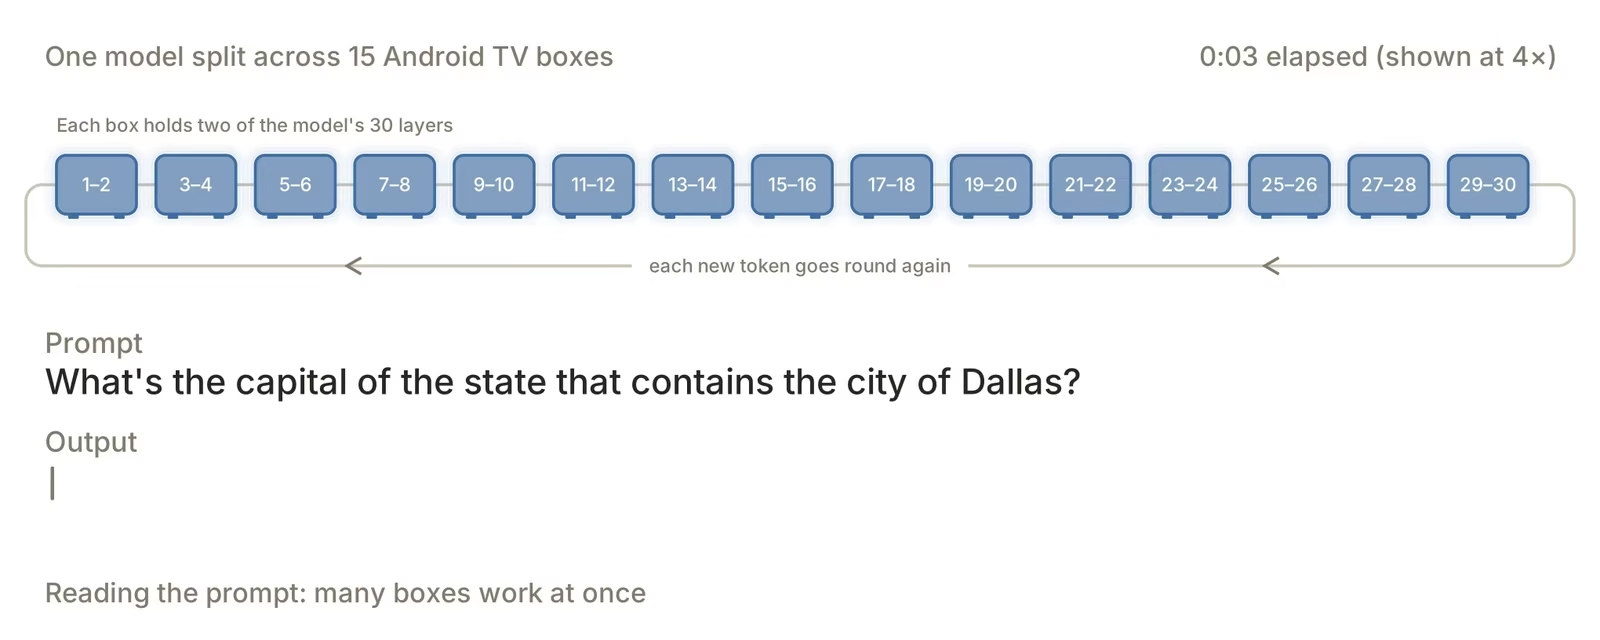
Anthropic repartió una IA entre 15 TV boxes de unos US$55 cada una: aproximadamente US$825 solo en dispositivos.
La IA funcionó a 0,39 tokens por segundo: aproximadamente un token cada 2,6 segundos.
Un token es un fragmento de texto: puede ser una palabra o parte de ella, como explica Hugging Face. Una sola frase puede necesitar varios tokens. Cuesta imaginar la paciencia necesaria para conversar a ese ritmo.
Por qué juntar tantas cajas
Un modelo de IA necesita caber en la memoria para trabajar. Dividirlo permite sumar la capacidad de varias máquinas: cada una guarda una parte y pasa los resultados a la siguiente. Es el principio de proyectos como Petals. La comunicación entre dispositivos también lleva tiempo y añade un coste al reparto.
¿Podría continuar por su cuenta?
¿Podría una IA encontrar otra computadora, copiarse a ella y seguir funcionando sin ayuda humana? El estudio investiga esa autonomía y el riesgo de usar máquinas sin permiso.
Otra prueba utilizó computadoras imitando TV boxes, con acceso sencillo. Una IA en otro servidor instaló otra IA allí. El experimento no demostró que una IA se copiara y siguiera funcionando por su cuenta fuera de las condiciones preparadas por los investigadores.
Fuentes
- Anthropic — AI models may be capable of self-replicating without access to a datacenter (2026-10-12)
- Petals: Collaborative Inference and Fine-tuning of Large Models (2023-03-02)
- Hugging Face — Tokenizers (Consultado el 2026-10-13)